Déploiements et incidents
Du déploiement au correctif de ce qu’il a cassé.
Chaque déploiement, avec les changements qu’il a livrés.
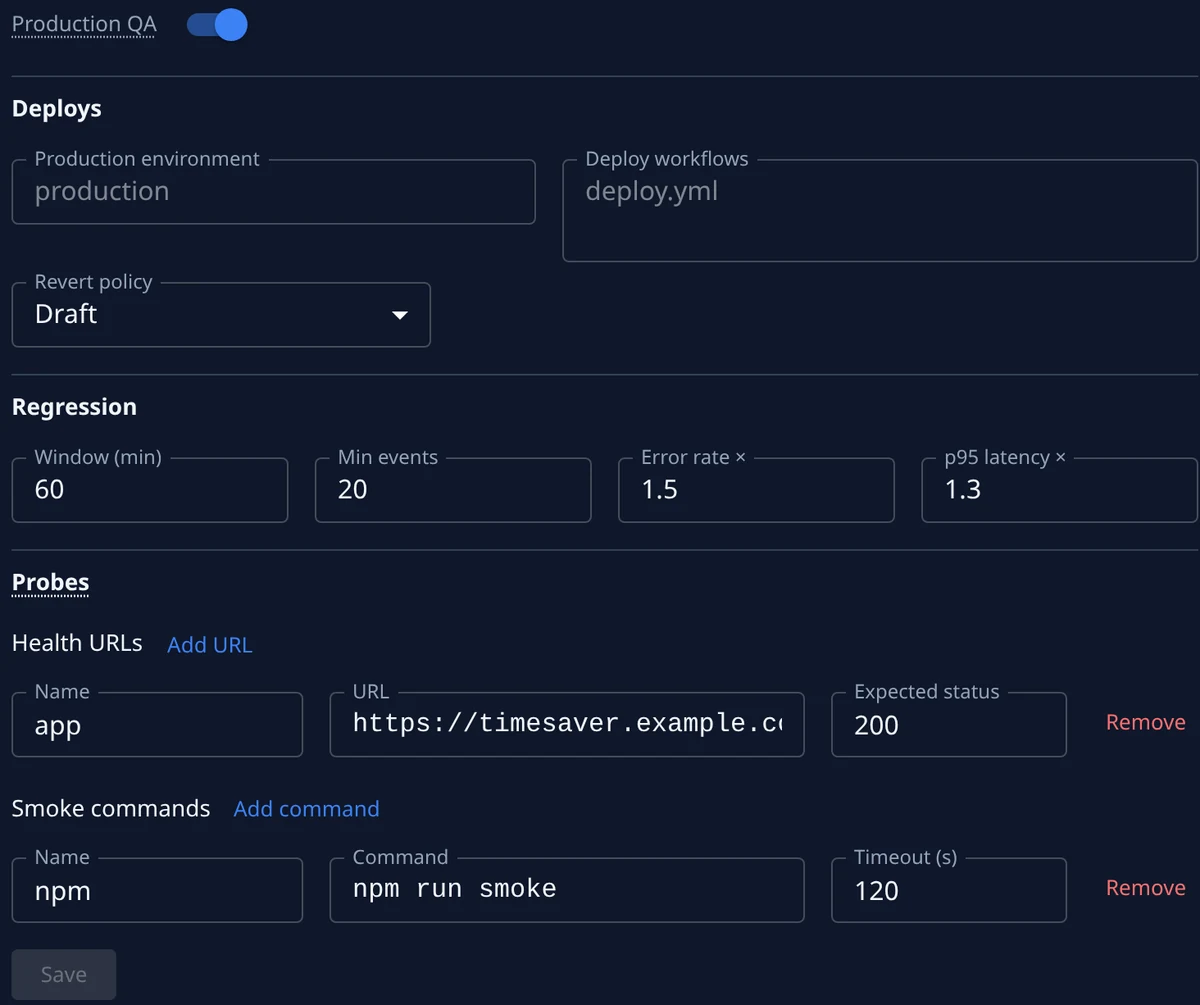
L’onglet Déploiements d’un projet montre ce qui attend sur Dev et ce qui est en ligne sur Production : appuyez sur Déployer pour livrer tout de suite les changements mergés, ou sur Planifier… pour choisir l’heure. Un gel bloque tout déploiement jusqu’à sa fin, un déploiement soumis à approbation attend que quelqu’un d’autre l’approuve. Vous êtes prévenu quand des changements sont prêts à déployer, demandent une approbation, passent en ligne ou échouent. Connectez une fois les déploiements du projet, depuis GitHub, GitLab, Bitbucket Pipelines ou Azure DevOps, et chaque exécution arrive sur la page Déploiements telle que votre pipeline la signale : en file, en cours, réussie ou en échec, avec les changements livrés. Après chaque déploiement en production, Jaah exécute vos contrôles de santé depuis l’une de vos machines, et un contrôle en échec ouvre un incident.
- Déployer maintenant ou planifier, avec gels et approbations
- GitHub, GitLab, Bitbucket et Azure DevOps
- Contrôles de santé après chaque déploiement en production
Un seul incident, qu’il sonne une fois ou cent., Bêta
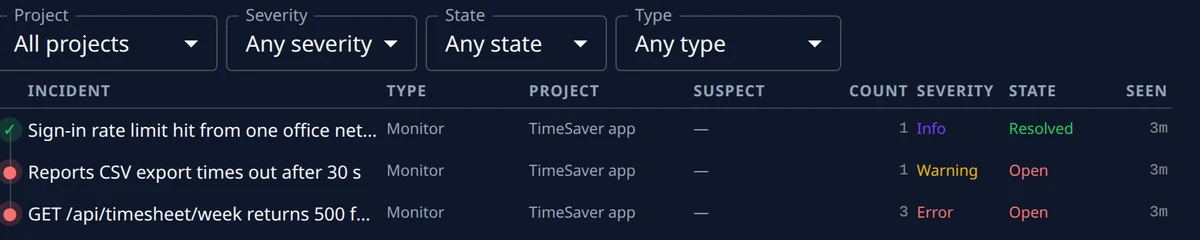
Connectez Sentry, Datadog, PagerDuty, CloudWatch ou tout outil qui envoie un webhook, et une alerte ouvre un incident, avec son type, sa gravité, le nombre de déclenchements et sa dernière apparition. Une répétition fait monter le compteur sur la même ligne, un incident résolu qui revient est rouvert, et son historique garde chaque étape. Chaque incident liste les changements mergés les plus probablement en cause, classés élevé, moyen ou faible, et vous pouvez confirmer un suspect, l’écarter ou en ajouter un autre.
- Sentry, Datadog, PagerDuty, CloudWatch ou un webhook
- Les répétitions comptées sur une ligne
- Le changement probablement en cause, classé
Un correctif pour l’incident, une annulation pour la version., Bêta
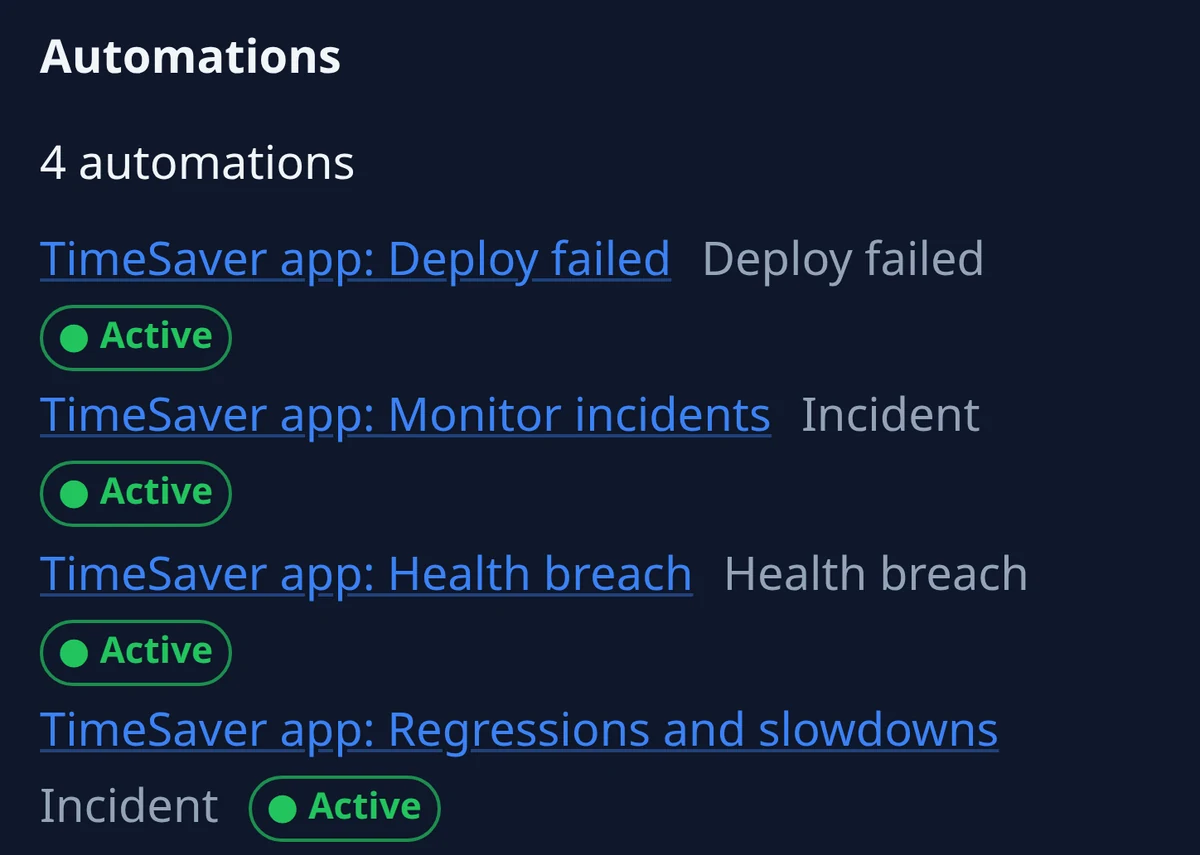
Activez les automatisations d’incident du projet, et un incident, un déploiement en échec ou un contrôle de santé en échec crée une tâche pour le corriger : un seul correctif ouvert par incident, qui nomme l’incident et ses suspects. Définissez la politique d’annulation du projet, et quand un déploiement en production fait monter le taux d’erreur ou ralentit les réponses par rapport à la même durée avant lui, Jaah crée une tâche qui l’annule. Cette tâche attend en brouillon que vous la lanciez, ou démarre d’elle-même. Dans les deux cas, elle passe par la revue et les mêmes contrôles que tout autre changement avant son merge.
- Un seul correctif ouvert par incident
- Plus d’erreurs ou des réponses plus lentes qu’avant le déploiement
- Une annulation en brouillon, ou lancée pour vous
Résultats
Ce que chaque changement est devenu après son merge.
Chaque changement est suivi au-delà du merge. Le Résultat, dans l’onglet Détails de la tâche, dit comment il s’en est sorti, à côté de son coût et des constats de sécurité qu’il portait.
- Mergé, déployé, toujours en place, annulé ou corrigé par un changement ultérieur
- Un incident relié au changement qui l’a causé
- Tokens et temps, à côté du coût
- Comparés par agent, modèle et configuration dans le centre de commande, avec la performance des agents dans votre offre
- Une configuration classée dès que son historique est assez long pour s’y fier
Chaque incident, avec ses suspects au poste.
Commencez gratuitement, connectez vos déploiements et votre supervision, et activez les automatisations d’incident : le prochain incident arrive avec sa tâche de correctif déjà créée.