Deployments & Incidents
Vom Deployment bis zum Fix für das, was es kaputt gemacht hat.
Jedes Deployment und was es ausgeliefert hat.
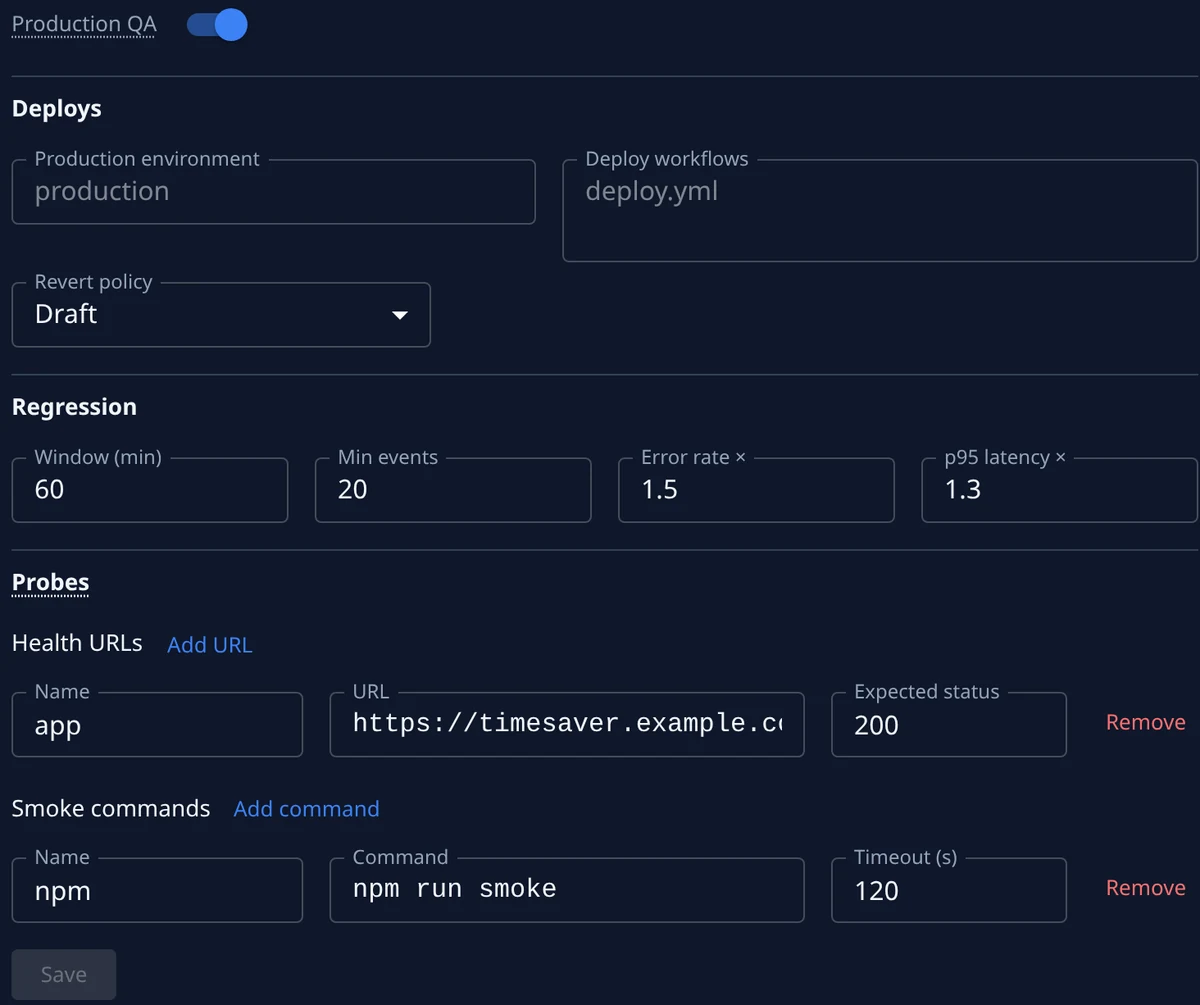
Der Tab „Deployments“ eines Projekts zeigt, was auf Dev wartet und was auf Production live ist: Drücken Sie „Deploy“, um die gemergten Änderungen sofort auszuliefern, oder „Schedule…“, um den Zeitpunkt zu wählen. Ein Freeze hält jedes Deployment an, bis er endet, und ein Deployment, das eine Freigabe braucht, wartet, bis jemand anderes es freigibt. Sie erfahren, wenn Änderungen bereit zum Deployment sind, eine Freigabe brauchen, live gehen oder fehlschlagen. Verbinden Sie die Deployments des Projekts einmal – aus GitHub, GitLab, Bitbucket Pipelines oder Azure DevOps –, und jeder Lauf landet auf der Seite „Deployments“, so wie Ihre Pipeline ihn meldet: wartend, im Deployment, erfolgreich oder fehlgeschlagen, mit den Änderungen, die er ausgeliefert hat. Nach jedem Produktions-Deployment führt Jaah Ihre Health-Checks auf einer Ihrer Maschinen aus, und ein fehlgeschlagener Check eröffnet einen Incident.
- Jetzt deployen oder planen, mit Freezes und Freigaben
- GitHub, GitLab, Bitbucket und Azure DevOps
- Health-Checks nach jedem Produktions-Deployment
Ein Incident, so oft er auch anschlägt., Beta
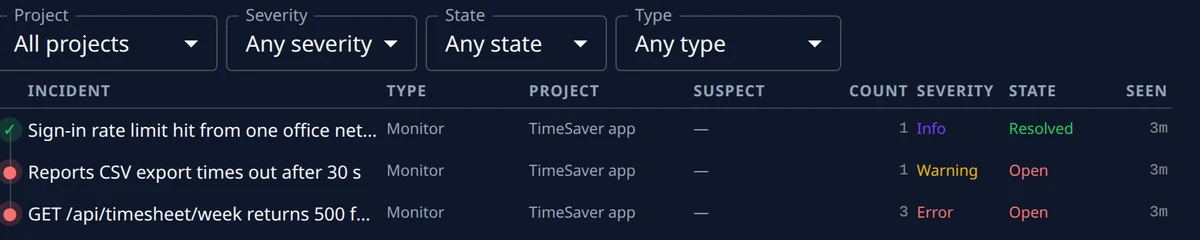
Verbinden Sie Sentry, Datadog, PagerDuty, CloudWatch oder alles, was einen Webhook sendet, und ein Alert eröffnet einen Incident – mit Typ, Schweregrad, wie oft er ausgelöst hat und wann er zuletzt gesehen wurde. Eine Wiederholung erhöht den Zähler in derselben Zeile, ein gelöster Incident, der wiederkommt, wird erneut geöffnet, und sein Verlauf hält jeden Schritt fest. Jeder Incident nennt die gemergten Änderungen, die am wahrscheinlichsten dahinterstecken, gereiht nach hoch, mittel oder niedrig, und Sie können einen Verdächtigen bestätigen, verwerfen oder einen weiteren hinzufügen.
- Sentry, Datadog, PagerDuty, CloudWatch oder ein Webhook
- Wiederholungen in einer Zeile gezählt
- Die wahrscheinliche Änderung dahinter, gereiht
Ein Fix für den Incident, ein Revert für das Release., Beta
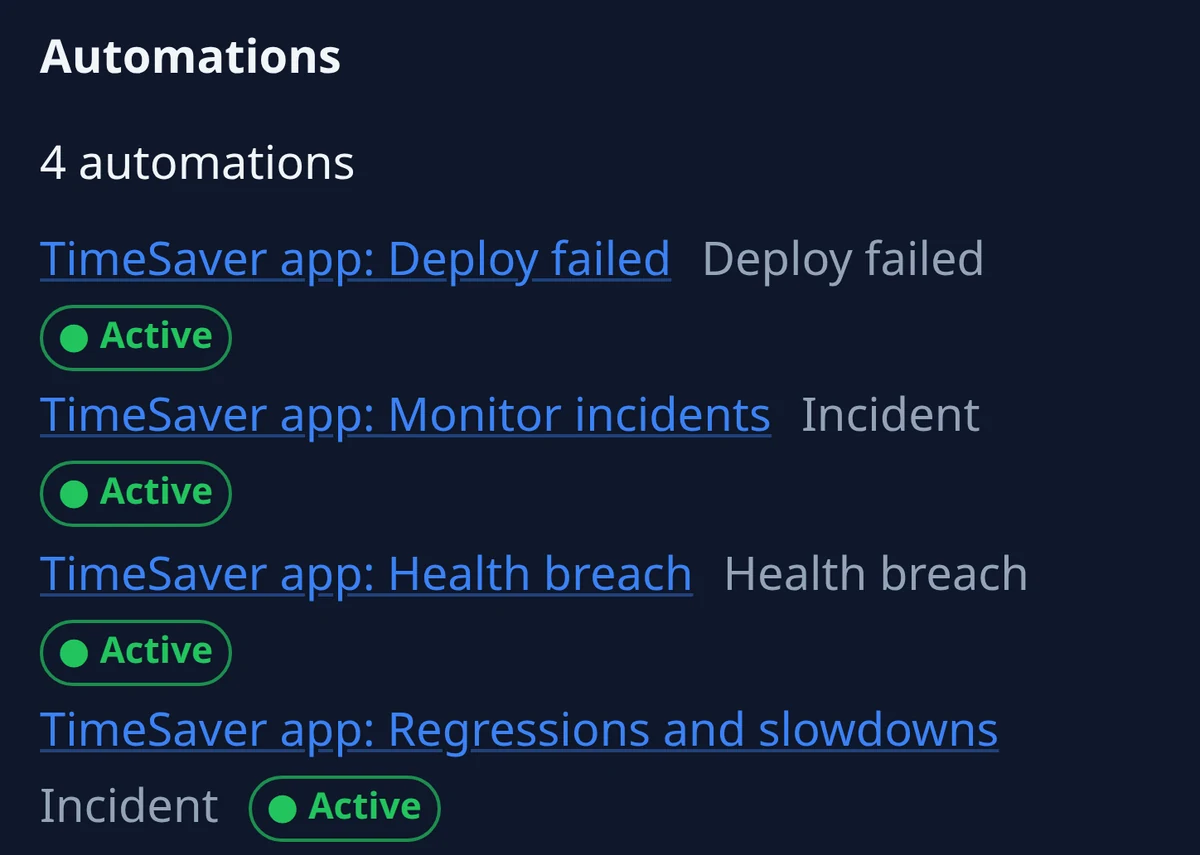
Schalten Sie die Incident-Automatisierungen des Projekts ein, und ein Incident, ein fehlgeschlagenes Deployment oder ein fehlgeschlagener Health-Check legt eine Aufgabe an, die ihn behebt: ein offener Fix pro Incident, mit dem Incident und seinen Verdächtigen. Legen Sie die Revert-Richtlinie des Projekts fest, und wenn ein Produktions-Deployment die Fehlerrate erhöht oder die Antworten verlangsamt, gemessen am gleichen Zeitraum davor, legt Jaah eine Aufgabe an, die es rückgängig macht. Diese Aufgabe wartet als Entwurf, bis Sie sie starten, oder startet von selbst. So oder so durchläuft sie vor dem Merge ein Review und dieselben Prüfungen wie jede andere Änderung.
- Eine offene Fix-Aufgabe pro Incident
- Mehr Fehler oder langsamere Antworten als vor dem Deployment
- Ein Revert als Entwurf oder gleich für Sie gestartet
Ergebnisse
Was aus jeder Änderung nach dem Merge wurde.
Jede Änderung wird über den Merge hinaus verfolgt. „Outcome“ im Tab „Details“ der Aufgabe zeigt, wie es lief – neben den Kosten und den Security-Befunden, die sie mitbrachte.
- Gemergt, deployt, steht noch, rückgängig gemacht oder von einer späteren Änderung behoben
- Ein Incident, zurückverknüpft mit der Änderung dahinter
- Tokens und Zeit neben den Kosten
- Verglichen pro Agent, Modell und Setup im Command center, mit Agenten-Performance in Ihrem Plan
- Ein Setup wird gereiht, sobald seine Bilanz lang genug für Vertrauen ist
Jeder Incident – mit den üblichen Verdächtigen.
Kostenlos starten, Deployments und Monitoring verbinden und die Incident-Automatisierungen einschalten: Dann kommt der nächste Incident mit fertig angelegter Fix-Aufgabe.